TL;DR — A inteligência artificial não lê palavras: ela lê números. Cada pedaço de texto que entra e sai do modelo é um token, e é exatamente isso que você paga. Entender tokens é o que separa um agente de IA que custa R$ 80 por mês de um idêntico que custa R$ 900. Este guia explica, do zero e sem matemática pesada, como a IA funciona por dentro — e mostra 9 ajustes práticos que derrubam a sua conta sem piorar o atendimento.
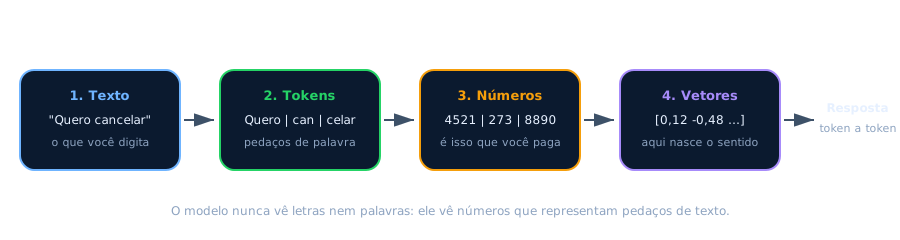
O caminho completo: o que você escreve vira pedaços, os pedaços viram números, e só então nasce o significado.
1. A ideia que explica tudo: o modelo não lê o que você escreve
Uma rede neural é, no fundo, uma máquina de multiplicar números. Ela não tem olhos, não conhece o alfabeto e não sabe o que é uma palavra. Então a primeira coisa que acontece com o seu texto é uma tradução: letras viram números.
Essa etapa se chama tokenização. Ela acontece antes do modelo, não é aprendida junto com ele: é uma tabela fixa, decidida uma única vez e congelada para sempre.
Um token é um pedaço de texto — uma palavra inteira, um pedaço de palavra, um sinal de pontuação — com um número associado. Nada mais que isso.
Atenção ao nome: "token" também significa outras coisas em tecnologia (a credencial de login, o ativo de blockchain). Aqui, token é sempre um pedaço de texto com um número.
Por que pedaços, e não palavras inteiras?
Três tentativas históricas explicam a escolha.
Tentativa 1 — um número por palavra. Monte um dicionário: "casa" → 41, "cachorro" → 892. Funciona até aparecer uma palavra fora da lista: um nome próprio, um erro de digitação, uma gíria. Aí o modelo escreve "desconhecido" e perde a informação para sempre. Pior: um dicionário real de português, com nomes e variações, passa de um milhão de entradas — grande demais.
Tentativa 2 — um número por letra. Resolve o desconhecido (são ~100 letras e símbolos), mas cria um problema pior: "internacionalização" vira 19 posições em vez de 1. E o custo de processar cresce com o quadrado do número de posições. Texto curto vira texto carésimo.
Tentativa 3 — um número por pedaço frequente. A sacada que venceu. Palavras comuns ("casa", "the") ganham um token só. Palavras raras se quebram em pedaços que já existem ("Rafhael" → R + af + ha + el). Nada é desconhecido, e o texto continua curto.
Esse é o BPE (Byte Pair Encoding), usado pelo GPT-2, pelo RoBERTa e, em variações, pelos modelos que você usa hoje.
A analogia do LEGO
Imagine uma fábrica de LEGO que precisa vender o menor número possível de tipos de peça, mas ainda permitir montar qualquer coisa. Ela não vende só tijolinhos 1×1 (você montaria tudo, mas gastaria 10 mil peças por modelo). Também não vende "Millennium Falcon já montado" (só serve para um modelo). Ela vende peças médias que aparecem muito: paredes, janelas, rodas.
O BPE é o algoritmo que descobre, olhando milhões de textos, quais peças médias valem a pena existir.
2. Como o vocabulário é construído (na prática)
O BPE roda uma vez, sobre um acervo gigante de texto, e produz uma lista de tokens e uma lista ordenada de fusões. O procedimento é quase bobo de tão simples:
- Comece com as letras (ou, no caso do GPT-2, com os 256 bytes possíveis).
- Conte todos os pares vizinhos no acervo inteiro: quantas vezes
tvem antes deh? - Funda o par mais frequente em um token novo.
- Repita. Agora
th+epode virarthe. - Pare quando o vocabulário atingir o tamanho desejado — no GPT-2, 50.257 tokens.
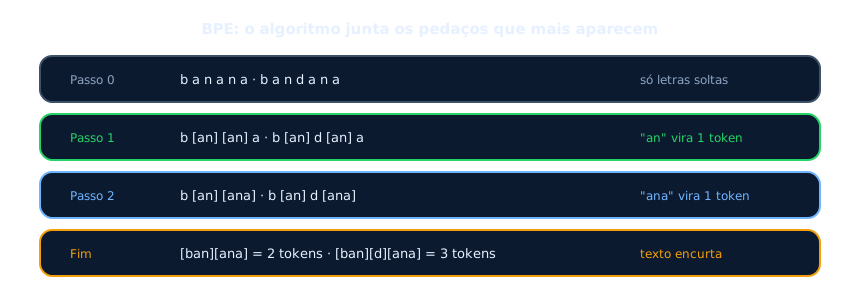
Com "banana" e "bandana": duas fusões bastam para "banana" custar 2 tokens em vez de 6.
Onde isso te afeta no bolso: português custa mais caro
O vocabulário é um retrato estatístico do texto usado no treino — e esse texto é majoritariamente em inglês.
| Idioma | Tokens por palavra (aprox.) | Efeito na conta |
|---|---|---|
| Inglês | 1,3 | referência |
| Espanhol | 1,8 | ~38% mais caro |
| Português | 2,0 a 2,4 | até 2× mais caro |
Não é que o modelo "não goste" de português. É que o algoritmo nunca teve motivo estatístico para criar um token único para ção. Resultado: o mesmo texto gasta quase o dobro de tokens, o dobro de memória, o dobro de tempo — e o dobro do preço.
Dois detalhes que explicam comportamentos estranhos
O espaço faz parte do token. casa e casa (com espaço na frente) são tokens diferentes, com números diferentes. Por isso: nunca termine um prompt com espaço. Escreva "O Brasil é" e deixe o modelo produzir o espaço sozinho — terminar com espaço joga o modelo para uma região estranha e a qualidade cai visivelmente.
Números viram picadinho. " 2024" costuma custar 1 token (ano muito frequente na internet), mas " 1234567" vira algo como 123 + 45 + 67 — pedaços sem nenhum significado aritmético. O modelo nunca enxerga o número inteiro. É literalmente por isso que modelos erram contas simples: eles não fazem matemática sobre números, e sim sobre fragmentos de dígitos escolhidos por frequência. Se o seu agente precisa somar valores, calcular frete ou conferir saldo, isso tem que sair do modelo e ir para uma integração.
3. Do número ao significado: os embeddings
Até aqui o texto virou uma lista de inteiros. Mas um inteiro não tem sentido: o número 41 não é "mais" nem "menos" que o 40.
O passo seguinte é o embedding: cada número vira uma lista de centenas ou milhares de casas decimais — um vetor. E esse vetor é aprendido durante o treino, de forma que pedaços com sentido parecido ficam perto uns dos outros nesse espaço.
Na prática, isso significa que para o modelo:
- "cancelar assinatura", "quero sair do plano" e "como faço pra encerrar" caem quase no mesmo lugar;
- "boleto", "fatura" e "cobrança" são vizinhos;
- "entrega atrasada" está longe de "elogio".
É daí que vem a mágica aparente: o agente entende uma pergunta que ninguém programou, porque ela está perto de algo que ele já viu.
Por que isso importa para o seu bolso? Porque embeddings são baratíssimos comparados a uma chamada de conversa. Usar embeddings para encontrar a resposta certa na sua base e só então mandar o trecho relevante para o modelo é a técnica que mais reduz custo em agentes de atendimento. Mandar o catálogo inteiro em toda mensagem é o erro mais caro que existe.
4. Onde o dinheiro realmente vai embora
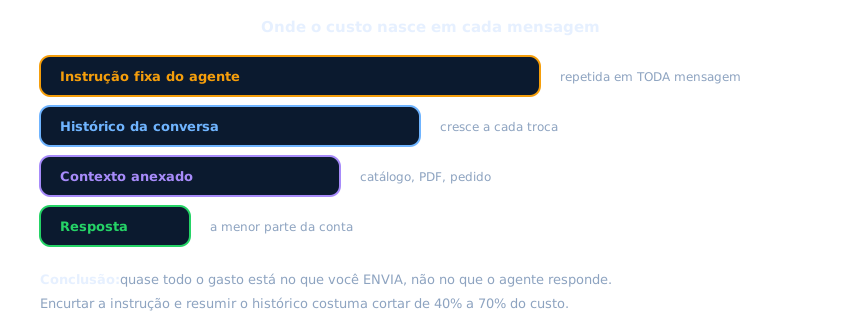
Em quase todo agente mal configurado, mais de 80% do custo está no que é ENVIADO, e não no que é respondido.
Toda vez que um cliente manda uma mensagem, o modelo recebe de novo:
- A instrução fixa do agente (personalidade, regras, tom, o que não pode falar) — reenviada em toda mensagem;
- O histórico da conversa — que cresce a cada troca;
- O contexto anexado — catálogo, política de trocas, dados do pedido;
- E só então gera a resposta.
Uma conversa de 20 mensagens com uma instrução de 1.500 tokens pode custar 30.000 tokens só de instrução repetida. Em português, dobre isso.
5. Nove ajustes que cortam a conta (sem piorar o atendimento)
1. Encurte a instrução do agente. Regra prática: se uma frase não muda o comportamento em nenhum caso real, apague. Instruções de 2.000 tokens quase sempre cabem em 400.
2. Escreva em tópicos, não em prosa. "Nunca prometa prazo" custa menos e funciona melhor que um parágrafo explicando o porquê.
3. Resuma o histórico. Depois de 8 a 10 mensagens, substitua as antigas por um resumo de 3 linhas. O cliente não percebe; a conta cai pela metade.
4. Busque antes de enviar. Em vez de anexar o catálogo inteiro, use busca por embeddings e envie só os 2 ou 3 trechos relevantes.
5. Use o modelo certo para cada tarefa. Classificar "isso é suporte ou vendas?" não precisa do modelo mais caro. Reserve o modelo forte para respostas ao cliente.
6. Tire cálculo e consulta do modelo. Frete, saldo, status de pedido, 2ª via de boleto: isso é integração, não IA. Mais barato, mais rápido e sempre certo.
7. Limite o tamanho da resposta. Respostas longas no WhatsApp não são lidas — e custam. Peça respostas de até 3 ou 4 linhas.
8. Não acione a IA em tudo. Menu, horário de funcionamento e endereço resolvem com fluxo fixo, a custo zero. A IA entra quando a pergunta é aberta.
9. Meça por conversa, não por mês. O número que importa é "quanto custa atender um cliente". Sem isso, você não sabe se otimizou.
6. Como fazemos isso na SimplesDesk
Boa parte dos ajustes acima é chata de fazer na mão. No SimplesDesk eles já vêm prontos:
- Créditos de IA visíveis por conversa e por agente, para você ver exatamente onde o gasto acontece — sem surpresa no fim do mês;
- Base de conhecimento com busca inteligente, que envia ao modelo só o trecho necessário em vez do documento inteiro;
- Resumo automático de histórico em conversas longas;
- Fluxos fixos para o que é repetitivo (menu, horário, 2ª via) e IA só onde ela agrega;
- Integrações nativas com ERP, CRM e gateways de cobrança, para que números venham do sistema — nunca "inventados" pelo modelo;
- WhatsApp oficial (Cloud API), Instagram, Telegram, e-mail e webchat no mesmo lugar, com o mesmo agente.
Na prática, clientes que migraram um agente configurado "na força bruta" para essa estrutura viram a conta de IA cair entre 40% e 70%, com a mesma taxa de resolução.
7. Perguntas frequentes
O que é exatamente um token?
Um pedaço de texto com um número associado. Pode ser uma palavra inteira, um pedaço dela ou um sinal de pontuação. É a unidade que o modelo lê e a unidade pela qual você paga.
Quantas palavras cabem em 1.000 tokens em português?
Aproximadamente 400 a 500 palavras. Em inglês, cerca de 750. A diferença vem do vocabulário do modelo, treinado majoritariamente em inglês.
Por que a IA erra contas simples?
Porque ela não vê o número inteiro. Um valor como 1234567 é quebrado em fragmentos de dígitos sem significado matemático. Cálculos devem ser feitos por integração, não pelo modelo.
Vale a pena escrever prompts em inglês para economizar?
Tecnicamente o texto fica mais curto, mas a resposta ao cliente precisa ser em português de qualidade. O ganho real está em encurtar a instrução e reduzir o contexto, não em trocar o idioma.
Embedding e token são a mesma coisa?
Não. O token é o pedaço de texto com um número. O embedding é a lista de casas decimais que representa o significado daquele token. Primeiro vem o token, depois o embedding.
O que mais encarece um agente de IA?
A instrução fixa e o contexto reenviados em toda mensagem. Na maioria dos casos, eles respondem por mais de 80% do consumo.
Ferramentas gratuitas SimplesDesk
Simule gratuitamente quanto custam conversas de marketing, utilidade, autenticação e serviço — com os preços atuais da Meta e o comparativo do novo modelo por template (vigente a partir de 1º de outubro de 2026).
Simular custos do WhatsApp →Estime o consumo de tokens do seu agente de IA (1 crédito = 1 milhão de tokens GPT-4.1 mini), veja o custo por conversa e baixe o orçamento em PDF.
Calcular consumo de IA →Continue lendo
Conteúdos úteis para o próximo passo da sua operação.